In het kort
- Generatieve AI (Engels: generative AI, afgekort GenAI) maakt nieuwe inhoud. Klassieke AI kiest of voorspelt uit bestaande opties.
- Een taalmodel voorspelt telkens het volgende stukje tekst. Het rekent met waarschijnlijkheid, niet met waarheid.
- In 2026 werkt generatieve AI steeds vaker als agent: het zoekt zelf in systemen, gebruikt gereedschap en legt een voorstel voor.
- Het grootste risico zijn verzonnen feiten en bronnen. Koppeling aan echte bronnen en controle door een mens verkleinen dat risico.
- Sinds 2 augustus 2026 moeten aanbieders AI-gegenereerde inhoud machineleesbaar markeren (artikel 50 AI Act).
Wat is generatieve AI?
Generatieve AI is kunstmatige intelligentie die zelf nieuwe inhoud maakt. Het model leert patronen uit grote hoeveelheden bestaande data en maakt daarmee iets nieuws: een tekst, een afbeelding, gesproken tekst, een tabel of een stuk broncode.
Het model kopieert geen bestaande zin. Het stelt een nieuwe zin samen die past bij wat het heeft geleerd. Zo kan het een brief, samenvatting of analyse schrijven die nergens anders bestaat.
Twee misverstanden geven in de praktijk de meeste problemen:
- Generatieve AI is geen zoekmachine. Een zoekmachine wijst u naar een document. Generatieve AI formuleert zelf een antwoord. Dat antwoord kan kloppen zonder dat er een document achter zit. Het kan ook niet kloppen zonder dat u dat aan de tekst ziet.
- Generatieve AI is geen beslisser. Het model levert een voorstel. Wie dat overneemt, is verantwoordelijk voor de inhoud. Lees ook wie aansprakelijk is als een AI-agent een fout maakt.
Wat betekent generatieve AI?
"Generatief" betekent voortbrengend: iets dat zelf iets nieuws maakt. Het woord komt van het Latijnse generare, voortbrengen. Generatieve AI is dus AI die inhoud voortbrengt. Andere AI deelt alleen in of voorspelt.
U komt het begrip onder verschillende namen tegen:
| Term | Waar u hem tegenkomt |
|---|---|
| Generatieve AI | de gangbare Nederlandse term |
| Generative AI | de Engelse term, met dezelfde betekenis |
| GenAI | de afkorting van generative artificial intelligence |
| Generatieve kunstmatige intelligentie | voluit, vooral in beleids- en onderwijsstukken |
| Large Language Model (LLM) | een generatief model dat gespecialiseerd is in taal |
Hoe werkt generatieve AI?
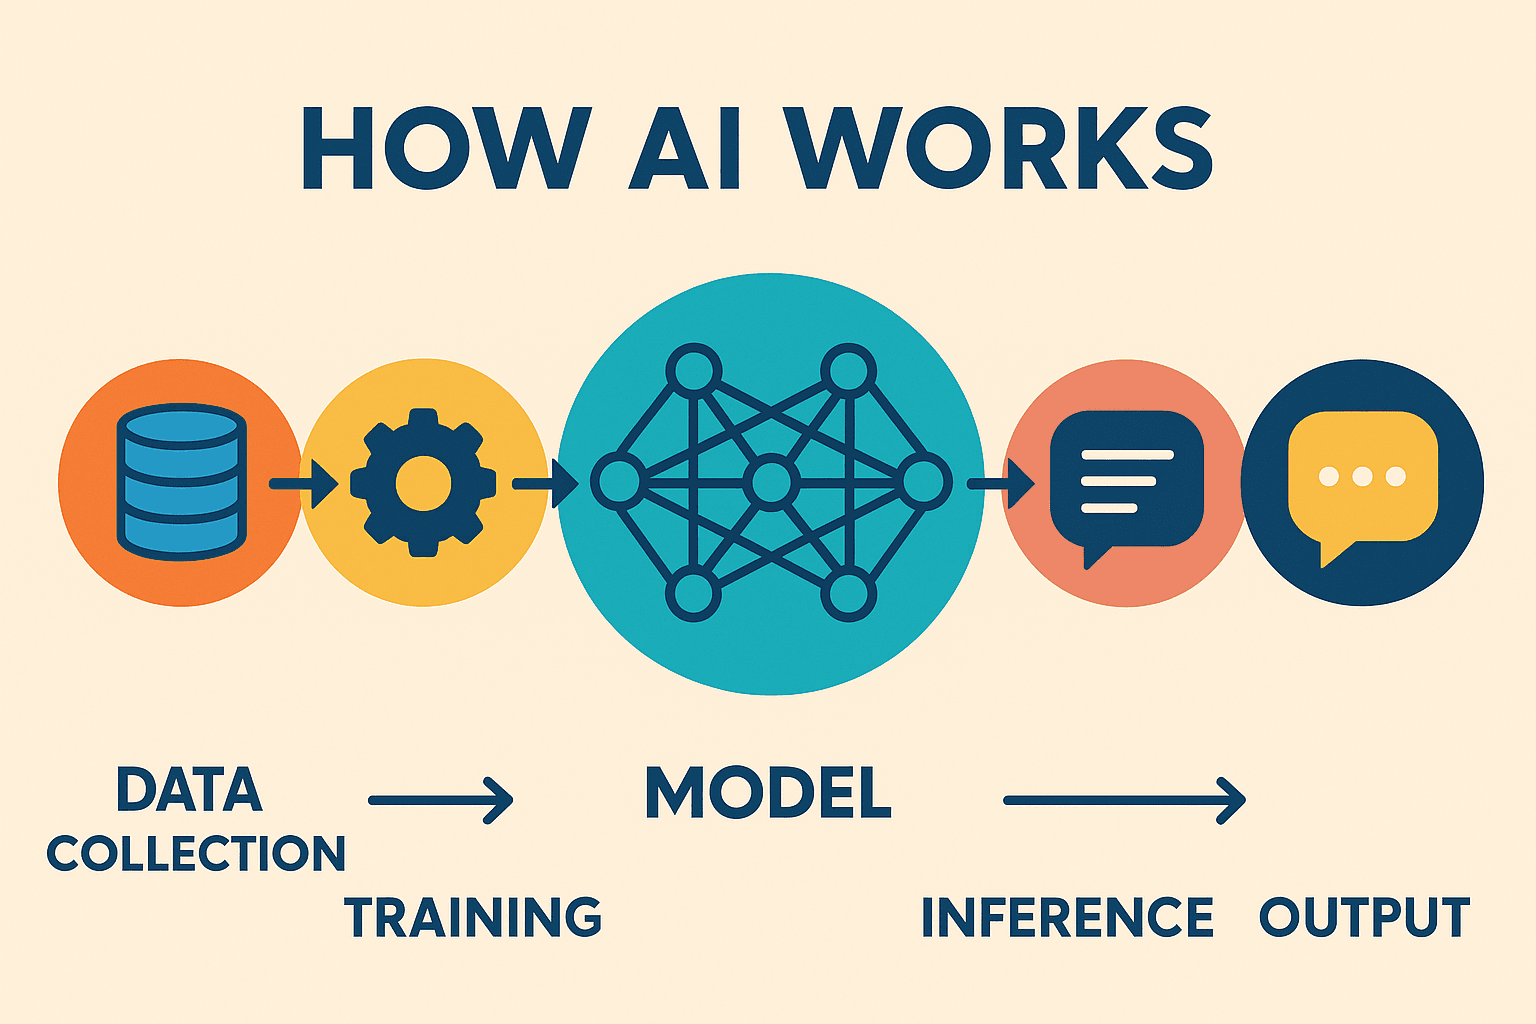
Een taalmodel voorspelt telkens het volgende stukje tekst. De schaal maakt dat bijzonder, niet het idee. Het werkt in vier stappen:
- Tekst wordt opgeknipt in tokens. Een token is een woord of een deel daarvan. "Huurovereenkomst" kan uiteenvallen in "huur", "overeen" en "komst".
- Het model berekent het meest waarschijnlijke volgende token. Bij "De huurder heeft de woning op 1 maart ..." zijn "opgeleverd" en "verlaten" waarschijnlijk. "Gefrituurd" is dat niet.
- Attention bepaalt wat meetelt. De transformer-architectuur weegt per token hoe zwaar elk eerder woord meetelt. Zo weet het model twintig zinnen later nog dat "hij" de huurder is.
- Het antwoord groeit token voor token. Elk gekozen token gaat terug de invoer in. Er zit bewust een beetje toeval in de keuze. Daarom krijgt u op dezelfde vraag zelden twee keer precies hetzelfde antwoord.
Het model rekent geen waarheid uit, maar waarschijnlijkheid. Een vloeiend en overtuigend antwoord is precies waarop het is getraind, of dat antwoord nu klopt of niet.
De kennis zit in miljarden getallen: de parameters. Die ontstaan in twee fasen. Eerst leest het model enorme hoeveelheden tekst en leert het taal. Dat heet voortraining. Daarna leert het van voorbeelden van goede antwoorden en van menselijke voorkeuren, zodat het instructies opvolgt.
Wat er in 2026 anders is. Moderne modellen verschillen op drie punten van de chatbots van een paar jaar geleden:
- Ze denken eerst na. Redeneermodellen werken een vraag eerst in tussenstappen uit en geven pas daarna antwoord. Dat kost meer tijd, maar helpt bij lastige vragen.
- Ze zijn multimodaal. Ze lezen niet alleen tekst, maar ook scans, tabellen, tekeningen en spraak.
- Ze gebruiken gereedschap. Een model kan zelf iets opzoeken, een bron opvragen of een berekening laten maken. Het Model Context Protocol (MCP) is daarvoor de open standaard geworden. Anthropic bracht MCP in december 2025 onder bij de Agentic AI Foundation van de Linux Foundation.
Wat is het verschil tussen generatieve AI en gewone AI?
Klassieke AI kiest of voorspelt uit bestaande opties. Generatieve AI maakt iets nieuws. Dat verschil bepaalt ook hoe u de uitkomst controleert.
| Klassieke (voorspellende) AI | Generatieve AI | |
|---|---|---|
| De vraag | "In welk hokje hoort dit?" of "Hoeveel wordt het?" | "Maak hier iets nieuws van" |
| De uitvoer | een label, een getal, een kans | tekst, beeld, code, een samenvatting |
| Voorbeeld | spamfilter, fraudesignalering, voorspellend onderhoud | conceptbrief, dossiersamenvatting, notulen |
| Typische fout | een geval verkeerd ingedeeld | vloeiend en onjuist tegelijk |
| Hoe u controleert | de foutmarge over veel gevallen | elk antwoord apart, op de bron |
De laatste rij is de belangrijkste. Bij een spamfilter accepteert u een foutpercentage over duizenden berichten. Bij generatieve AI helpt een gemiddelde u niet. Eén verzonnen verwijzing in één brief is al een probleem.
Wat zijn LLM's, en hoe verhouden ze zich tot AI-agents?
Een Large Language Model (LLM) is een generatief model voor taal. Het is getraind op boeken, nieuws, wetteksten, fora en broncode. Bekende modelfamilies zijn GPT (OpenAI), Claude (Anthropic), Gemini (Google), Llama (Meta), Mistral (Frankrijk) en DeepSeek en Qwen (China).
De begrippen rond generatieve AI zijn geen synoniemen. Het zijn lagen die in elkaar passen:
- Kunstmatige intelligentie (AI): het hele vakgebied.
- Machine learning: systemen die hun gedrag uit data afleiden in plaats van uit vaste regels.
- Deep learning: machine learning met neurale netwerken van veel lagen.
- Generatieve AI: deep learning die nieuwe inhoud maakt. Hier horen de LLM's.
- AI-agents: generatieve AI die gereedschap gebruikt en een taak uitvoert. Een agent zoekt op, rekent, schrijft een concept en beoordeelt zijn eigen tussenresultaat.
Een chatbot beantwoordt een vraag. Een agent voert een taak uit. Daarmee verandert ook de controlevraag. Het gaat niet alleen om "klopt dit antwoord?", maar ook om "welke stappen zijn gezet en welke bronnen zijn gebruikt?"
Wat zijn voorbeelden van generatieve AI in 2026?
De sterkste toepassingen hebben één ding gemeen: het model werkt met echte, gecontroleerde bronnen in plaats van uit zijn geheugen.
| Soort | Voorbeeld uit de praktijk |
|---|---|
| Tekst | een conceptbrief, de samenvatting van een jaarverslag, notulen uit een opname |
| Onderzoek | uitspraken zoeken op rechtsgebied en instantie, met de volledige tekst per ECLI |
| Documenten en beeld | een gescande akte of bouwtekening uitlezen en naast de eisen leggen |
| Spraak | een zorgrapportage opstellen uit wat een medewerker inspreekt |
| Code | een functie laten schrijven en daarna laten testen |
| Agents | een assistent zoekt risico's in beleidsstukken en legt voorstellen ter goedkeuring voor |
Per sector ziet dat er in Nederland zo uit:
- Juridisch werk. Uitspraken zoeken, de volledige tekst ophalen en zien welke uitspraken naar elkaar verwijzen. Advocaten werken daarbij sinds december 2025 met aanbevelingen van de NOvA over AI. Lees wat de NOvA-aanbevelingen voor uw kantoor betekenen. Hoe dat zoekwerk met een AI-assistent gaat, ziet u bij juridisch onderzoek met AI.
- Openbaar bestuur. Bij een Woo-verzoek markeert AI de passages met persoonsgegevens en stelt een lakvoorstel op. De behandelaar beslist.
- Bouw. Een bouwplan naast het Besluit bouwwerken leefomgeving en de Wet kwaliteitsborging voor het bouwen leggen, en benoemen waar de onderbouwing ontbreekt.
- Zorg. Een rapportage opstellen uit wat een zorgverlener inspreekt, gekoppeld aan het cliëntdossier.
- Interne kennis. Medewerkers vragen in gewone taal naar een werkinstructie en krijgen een antwoord met een verwijzing naar het document.
Hoe betrouwbaar is generatieve AI?
Generatieve AI is zo betrouwbaar als de bronnen waaraan u het koppelt en de controle die u organiseert. Zonder bronnen verzint een model soms feiten. Die zien er net zo overtuigend uit als echte.
Waar het misgaat
- Hallucinatie. Het model verzint iets dat logisch klinkt maar niet bestaat. Vraag een assistent zonder bronkoppeling naar een uitspraak van de Hoge Raad, en u kunt een keurig ECLI-nummer terugkrijgen dat nergens naar verwijst. Lees ook waarom AI Nederlandse jurisprudentie verzint.
- Een bronvermelding die niet klopt. Zonder koppeling aan een bronsysteem kan een model geen echte vindplaats geven. Vraagt u er toch om, dan maakt het er een.
- Verouderde kennis. Een model kent de wereld tot het moment van training. Een wetswijziging van vorige maand zit er niet in, tenzij het model die live kan opvragen.
- Bias. Wat in de trainingsdata vaak voorkomt, komt terug in de uitvoer. Bij teksten over mensen is dat een reëel risico.
- Te snel overnemen. Een vloeiend antwoord nodigt niet uit tot controle. Daarom moet die controle georganiseerd zijn.
Wat helpt
| Maatregel | Wat het doet |
|---|---|
| RAG (retrieval-augmented generation) | geeft het model passages uit een ingelezen kennisbank mee, zodat het antwoord op documenten steunt |
| Live koppeling | laat het model de bron raadplegen op het moment van de vraag, bijvoorbeeld via MCP |
| Bronvermelding om door te klikken | maakt controle mogelijk in één klik |
| Vier ogen | een vakinhoudelijk expert beoordeelt het resultaat voordat het naar buiten gaat |
| Tweede model als controleur | een ander model toetst of de onderbouwing klopt en de bronnen bestaan |
| Vastleggen | welke vraag, welk model, welke bronnen en wie het heeft goedgekeurd |
Hoe meet u betrouwbaarheid? Met benchmarks: vaste toetsen waarop modellen worden gescoord. Die zeggen veel, maar niet alles. Voor de Vals AI Legal Research Bench schreven advocaten de vragen en de beoordelingspunten. Een taalmodel beoordeelt de antwoorden daarop. In september 2026 deelden daar drie modellen de eerste plaats, met 55,29% antwoorden waarin alle beoordelingspunten goed waren. De standaardfout is ongeveer 3,5 procentpunt, dus de beste acht modellen verschillen statistisch niet van elkaar. Het zwaarste onderdeel is tegenstrijdige bronnen met elkaar verzoenen: over alle geteste modellen samen was daar maar ongeveer een vijfde van de antwoorden helemaal goed. En die toets gaat over Amerikaans recht.
Een onafhankelijke, peer-reviewed benchmark voor juridisch onderzoek in het Nederlands, op basis van Nederlands recht, bestaat op dit moment niet. Daarom bouwen wij er zelf een. Resultaten daarvan zijn er nog niet. Op PrudentBench houden we bij hoe modellen scoren op de bestaande toetsen, en welke modellen door onze compliancepoort komen.
Waar begint uw organisatie met generatieve AI?
Begin bij het werk, niet bij de tool. Drie vragen helpen u verder dan een proefabonnement:
- Welk werk kost veel tijd zonder dat er vakmanschap in zit? Zoeken, samenvatten, overtypen. Daar zit de winst, niet in het oordeel zelf.
- Op welke bron moet het antwoord staan? Geen bron, geen toepassing.
- Wie controleert, en hoe legt u dat vast? Zonder antwoord daarop is de toepassing niet af.
Vraag een leverancier daarnaast:
- Kan ik vanuit elk antwoord doorklikken naar de bron?
- Waar staan onze gegevens, wordt erop getraind en hoe lang worden ze bewaard?
- Hoe is de menselijke controle ingericht, en wat wordt er gelogd?
- Wat gebeurt er als het onderliggende model wordt vervangen?
- Wat kost het per gebruiker per maand, en wat zit daarbij in?
Zorg ook dat medewerkers weten wat een model wel en niet kan. De AI Act vraagt aanbieders en gebruikers van AI-systemen om maatregelen die de AI-geletterdheid van hun mensen ondersteunen (artikel 4). Meer daarover leest u in AI-geletterdheid onder de AI Act.
Zo werkt het bij Prudai
Drie keuzes in onze AI-collega's volgen direct uit hoe generatieve AI werkt.
- Eerst de bron, dan het antwoord. LEO, VERA, ZIA, BEVER en IRMA werken op één gedeelde bronnenregistry met meer dan honderd gevalideerde bronnen. Een deel daarvan wordt live bij de bron zelf opgevraagd. Een ander deel is ingelezen als kennisbank. De openbare bronnen staan op onze pagina kennisbronnen.
- Een mens beslist over wat er wordt vastgelegd. In IRMA komen AI-voorstellen voor risico's, maatregelen, processtappen en conceptbeleid pas in het register nadat een medewerker ze heeft goedgekeurd. Elke goedgekeurde wijziging staat in de auditlog, en de AI-voorstellen staan standaard uit. ZIA kan in Nedap ONS één ding terugschrijven, een dagrapport, en vraagt daarvoor altijd eerst de bevestiging van de medewerker. Ook die koppeling staat standaard uit.
- Niet elk sterk model komt erin. Voordat een model bij ons in productie mag, moet het door de compliancepoort: contractuele EU-verwerking, een aanvaardbare verwerkersketen en geen verplichte dataretentie bij de leverancier. Sommige modellen die hoog scoren, halen die poort niet.
Daarnaast publiceerden we rechtspraak-mcp als open source, onder de MIT-licentie. Daarmee haalt een AI-assistent uitspraken rechtstreeks uit de Open Data van de Rechtspraak, in plaats van ze te verzinnen. Zelf zoeken in de uitspraken kan op prudai.com/jurisprudentie.
Voor de specialist
- Contextvenster. Het aantal tokens dat een model in één keer kan meenemen. Wat erbuiten valt, ziet het model niet. Lange dossiers worden daarom in delen verwerkt of via retrieval opgehaald.
- Temperatuur. De instelling die bepaalt hoeveel toeval er in de tokenkeuze zit. Lager is voorspelbaarder, hoger is gevarieerder.
- Open gewichten zijn geen open source. Bij open gewichten zijn de parameters vrij te downloaden, maar de trainingsdata en het trainingsrecept meestal niet. Wel kunt u zo'n model op eigen infrastructuur draaien.
- RAG of live koppeling. RAG werkt met een ingelezen kopie, en die kan verouderen. Een live koppeling vraagt de bron op het moment zelf op. Voor wetgeving en rechtspraak is die actualiteit vaak beslissend.
- Artikel 50 AI Act. Aanbieders moeten synthetische tekst, beeld, audio en video machineleesbaar markeren als kunstmatig gegenereerd. Die plicht geldt sinds 2 augustus 2026. Systemen die daarvoor al op de markt waren, hebben tot 2 december 2026 (Verordening (EU) 2026/1744). Er zijn uitzonderingen, onder meer voor AI die alleen helpt bij standaard redactiewerk. Meer in artikel 50 AI Act.
- Hoog-risico-AI. Door dezelfde wijzigingsverordening gelden de eisen voor hoog-risicosystemen uit bijlage III van de AI Act vanaf 2 december 2027. Voor systemen onder bijlage I is dat 2 augustus 2028.
Veelgestelde vragen
Wat is generatieve AI in één zin?
Generatieve AI is kunstmatige intelligentie die zelf nieuwe inhoud maakt, zoals tekst, beeld, geluid of code. Dat doet het op basis van patronen die het heeft geleerd uit grote hoeveelheden bestaande data.
Wat betekent GenAI?
GenAI is de afkorting van generative artificial intelligence. Het betekent hetzelfde als generatieve AI.
Is ChatGPT generatieve AI?
Ja. ChatGPT is een toepassing die is gebouwd op een generatief taalmodel. Generatieve AI is de onderliggende technologie, en die zit ook in veel zoek-, schrijf- en rapportagetools.
Waarom verzint generatieve AI soms dingen?
Het model is getraind om aannemelijke tekst te maken, niet om feiten te controleren. Ontbreekt de kennis, dan geeft het toch het meest waarschijnlijke antwoord, soms met een bronverwijzing die niet bestaat. Koppeling aan echte bronnen en controle door een mens verkleinen dat risico.
Is generatieve AI veilig voor vertrouwelijke gegevens?
Dat hangt af van de inrichting, niet van de technologie. Vraag waar de gegevens staan, of erop wordt getraind, hoe lang ze worden bewaard en wie erbij kan. Leg de antwoorden vast in de overeenkomst.
Bronnen
- Verordening (EU) 2024/1689 (AI Act), Publicatieblad 12 juli 2024
- Verordening (EU) 2026/1744 (Digital Omnibus on AI), Publicatieblad 24 juli 2026
- Model Context Protocol: MCP joins the Agentic AI Foundation, 9 december 2025
- Vals AI, Legal Research Bench (stand 29 september 2026)
- De Rechtspraak, Open Data
- rechtspraak-mcp op GitHub (MIT-licentie)
Wilt u weten hoe generatieve AI werkt als hij aan echte bronnen vastzit en een mens het laatste woord heeft? Bekijk de AI-collega's van Prudai.
Bijgewerkt op 2 oktober 2026