In 2026 draaien AI-agents operationeel mee in veel Nederlandse organisaties. Ze beantwoorden klantvragen, controleren documenten en bereiden inkooporders voor. Maar hoewel de intelligentie van deze agents flink is toegenomen, blijft het fundament vaak wankel: de bedrijfsinformatie ligt verspreid over wiki's, gedeelde mailboxen, verouderde DMS'en en geïsoleerde chatgeschiedenissen.
Mensen kunnen met die ambiguïteit omgaan; voor AI-agents is deze fragmentatie desastreus. Een agent die uit drie conflicterende systemen zijn instructies moet halen, gaat onherroepelijk fouten maken of hallucineren.
Twee regels die sinds augustus 2026 gelden
Sinds augustus 2026 gelden twee regels die het datavraagstuk acuut maken. Sinds 2 augustus 2026 geldt de transparantieverplichting uit de EU AI Act (artikel 50). Sinds 15 augustus 2026 geldt de Cyberbeveiligingswet, met een strikte meldplicht voor incidenten binnen 24 uur.
Beide regelgevingen veronderstellen een niveau van controle dat veel organisaties momenteel niet hebben. U kunt pas transparant zijn over de werking van AI, of binnen 24 uur rapporteren over een inbreuk, als u exact wéét welke informatie waar staat en wie of wát erbij kan. Dit vereist dat organisaties afscheid nemen van rondslingerende spreadsheets en overstappen op een structureel, gecontroleerd fundament.
Leren van de overheid: de overstap naar Knowledge Graphs
Interessant genoeg is het de Nederlandse overheid die op dit vlak voorloopt en deze lessen al heeft geïnstitutionaliseerd. Kaders zoals de Nederlandse Overheid Referentie Architectuur (NORA) en praktische toepassingen zoals de Kadaster Knowledge Graph tonen aan hoe u informatie objectiveert en eenduidig ontsluit (conform de FAIR-principes). Veel commerciële bedrijven lopen op dit fundament nog achter en kampen met een onbeheersbare 'scatter-crisis'.
De praktijk: één feit, één plek
Bij Prudai werken we zelf dagelijks met AI-agents, naast onze mensen. Voor onze AI Services hanteren wij dan ook een strak informatiemanagement-protocol, gebaseerd op praktijkervaring en niet enkel op theorie.
Onze belangrijkste vuistregel: er is slechts één canonieke bron per feit. We werken met getypeerde datastores en strikte lifecycle-regels. Informatie wordt bij ons niet gedupliceerd, maar 'promoveert' van een tijdelijke status naar een definitieve canonieke bron naarmate de zekerheid toeneemt. Dit doen we met een vaste hygiënecadans. Zo werken LEO, VERA, ZIA, BEVER en IRMA op één gedeelde bronnenregistry met meer dan honderd gevalideerde bronnen.
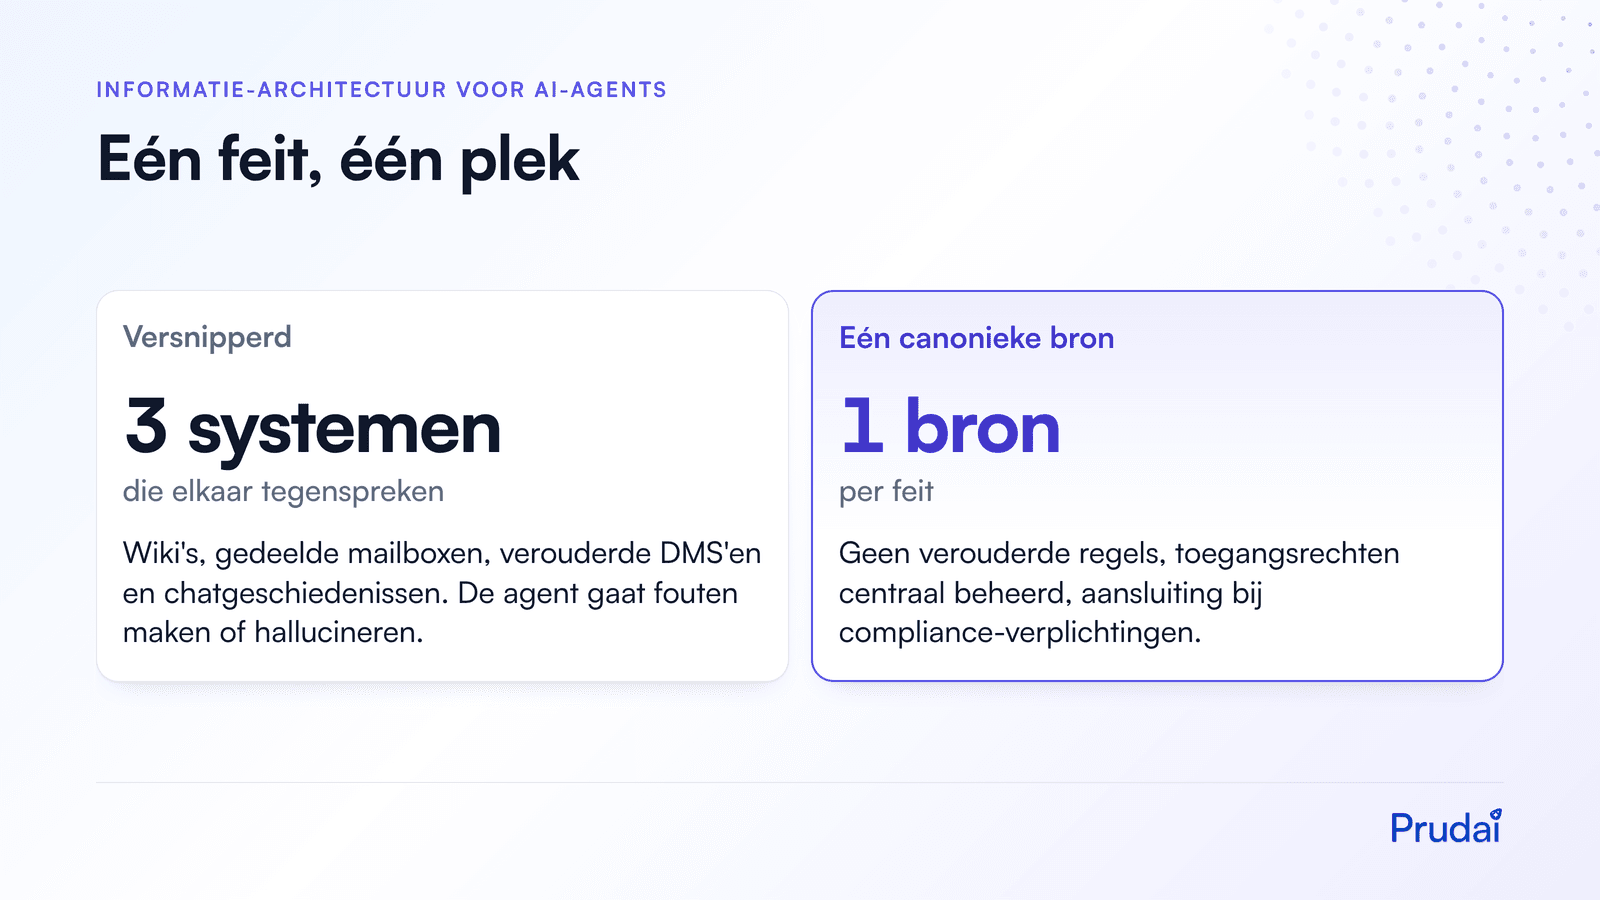
Vergelijking: versnipperde informatie in drie systemen die elkaar tegenspreken, waardoor een agent fouten maakt, tegenover één canonieke bron per feit.
Hoe een agent in zo'n bron vervolgens de juiste passage vindt, en waarom wij overstapten van alleen vectorzoeken naar hybride zoeken, leest u in Verder dan vector search.
Door informatie op één plek te borgen, voorkomen we dat agents verouderde regels toepassen, kunnen we toegangsrechten centraal beheren en sluiten we naadloos aan bij compliance-verplichtingen. Eén feit, één plek is de enige schaalbare route naar een betrouwbare, agent-gedreven organisatie.
Wat zo'n organisatie verder vraagt van teams en leiders, van afspraken over controle tot een werkend operating model, leest u in De AI-enabled organisatie in 2026.
Bronnen
- Nederlandse Overheid Referentie Architectuur (NORA): het interoperabiliteitskader van de Nederlandse overheid
- Kadaster Knowledge Graph: praktijkvoorbeeld van eenduidig ontsloten overheidsdata
- FAIR-principes (GO FAIR): Findable, Accessible, Interoperable, Reusable
- Forum Standaardisatie: de lijst met verplichte open standaarden voor de Nederlandse overheid
Wilt u weten hoe wij uw datalandschap structureren zodat uw organisatie veilig voldoet aan de regels die sinds augustus 2026 gelden, of wilt u direct kennismaken met onze aanpak voor AI-agents? Neem dan contact met ons op voor een nuchter gesprek over uw informatie-architectuur.